JEV 是什么
TypeSafe 发布的 JEV 是个纯粹的判断模型(官方叫 System One)。它不做长文本生成,也不跟你聊天:你扔给它一段输入并设定几个问题,它直接返回离散分类、打分或概率值。
日常业务代码里其实堆满了这类分支判断:工单分发到哪个组、内容是否违规、退款申请急不急。这些逻辑传统上靠正则或规则引擎搞不定,靠大语言模型又太重——每次为了拿一个状态枚举,都得拉起几十上百亿参数的模型吐几十个 token,延迟高还经常要担心 JSON 格式偶尔被截断。
Hardy Chen 在《把 JEV 用对地方》里提过类似的分工:先用 JEV 把百来篇抓取文章里有实操价值的筛出来,真正需要深读、提炼的内容再交给 Codex 处理。落到 Java 后端常见的工单系统也是一样,JEV 只管快速分流和标定紧急度,后续如果要写客诉回信或排查堆栈,再交给通用大模型。
Java 快速上手
封装好的 Starter 已发布到了 Maven 中央仓库(版本 0.1.0),在项目里引入依赖:
1 | <dependency> |
在 application.yml 里填上 TypeSafe 的 API Key:
1 | jev: |
直接注入 JevClient 就能调用,不需要配置额外的 @Enable* 注解:
1 |
|
这里 team 是自定义的问题键,Map 的 key 是业务系统落库用的枚举值,value 则是给模型的判断依据。如果传入“账单重复扣费了,请帮我退回多扣的钱”,拿到的 response.choice("team").choice() 就是 billing。
它直接返回确定的字符串,省掉了从模型生成的自然语言里提取 JSON 的步骤。业务规则变动时改 Map 中的职责描述即可,分发逻辑本身仍旧是原生 Java 代码。
复合条件评估
实际分流很少只看单一维度。比如同样是集成故障,有的系统只是报个警告,有的则是核心链路中断。可以在一次 evaluate 调用里组合多个维度:
1 | var ticket = Map.of("message", |
严重程度设置了三档,对应 0、1、2,模型计算后会给出一个加权分(带小数)。
测试接口:
1 | curl -sS http://127.0.0.1:18080/triage \ |
返回数据:
1 | { |
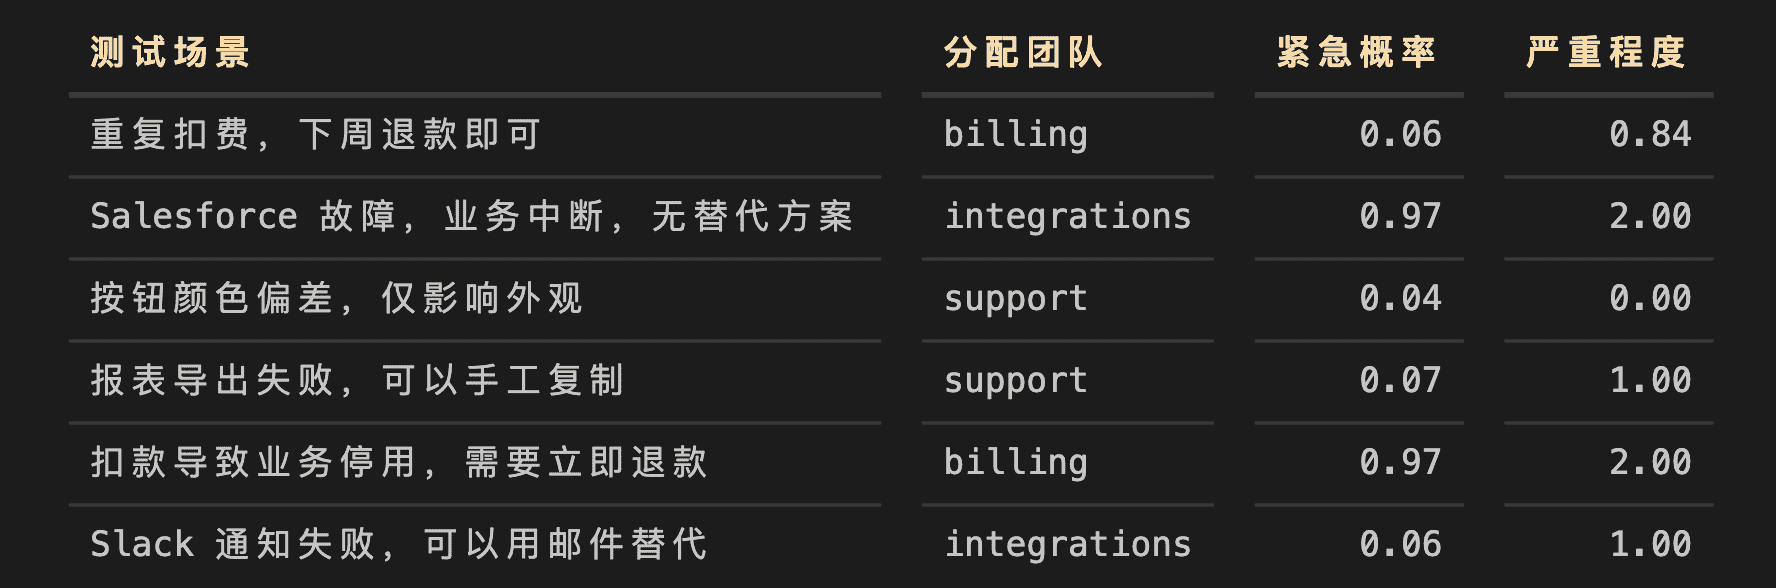
这比单纯吐一个团队名有用得多:系统能依据 severity >= 1.8 且 urgency > 0.9 自动把工单推进加急队列。
需要分清的是,confidence 表示分类的概率置信度,而 urgency 是紧急概率本身。即便 confidence 是 1.0,也只代表模型对选择该团队很有把握,业务线上还是得用一批典型样本把阈值校准好。
相比通用大模型,底层逻辑有什么不同
很多人会问:OpenAI 很早就支持了带 JSON Schema 的 Structured Outputs,把输出锁定在特定的枚举里,这和 JEV 有何区别?
关键在底层推理机制。
以分团队为例,OpenAI 的 Structured Outputs 依然是自回归语言模型。它在生成每个 token 时,通过语法掩码强制模型只能从符合 Schema 的 token 中采样。虽然格式得到了保证,但它本质上还是在“说话”,只是嘴被堵得只能说特定单词。应用层仍然要应对模型拒绝作答、上下文截断等情况。
JEV 这类判别模型则是按 TypeSafe 的设计规格,直接在最后一层输出离散分类与概率分布。同一批次下的多个判断是并行计算的,不依赖自回归循环逐字吐字。
两者的概率质量也有本质不同。让通用大模型在 JSON 里顺带填一个 confidence: 0.95,这个数值只是模型“写出来的文本”,没有经过统计学上的置信度校准;JEV 的 confidence 是从各分支归一化的 Softmax 分布直接算出来的,Noul 则对应二元判定的后验概率。
不过,判断模型并不意味着万能或绝对更便宜。通用模型生态卷得很厉害,廉价模型调用成本已经极低。如果一个场景既需要分类,又需要顺便总结故障、生成一段回复,直接调通用大模型一次搞定反而更划算;但如果你在处理每分钟成百上千次的高频过滤与路由,判别式接口的延迟和确定性才是重点。
内网私有化备选:Laya
业务数据如果不能出机房,可以看看开源的 Laya。
Laya 开放了模型权重,同样实现了 choice、score、noul 的判定接口。Java 项目如果要接,通常是在内网用 Python 把 Laya 封装成一个标准的 HTTP/gRPC 推理服务,再在 Spring Boot 这一侧写个轻量客户端对接。它并不是 JEV 的官方开源实现,两者协议并不完全通用,不能简单地换个 Base URL。
私有化自建意味着要自己抗 GPU 资源和维护成本。Laya 官方文档也明确提到过多语言下的过拟合与置信度偏差问题。上线之前,必须拿自己业务里积累的历史工单跑一次混淆矩阵,确认准确率和响应延迟能达到预期再作决定。