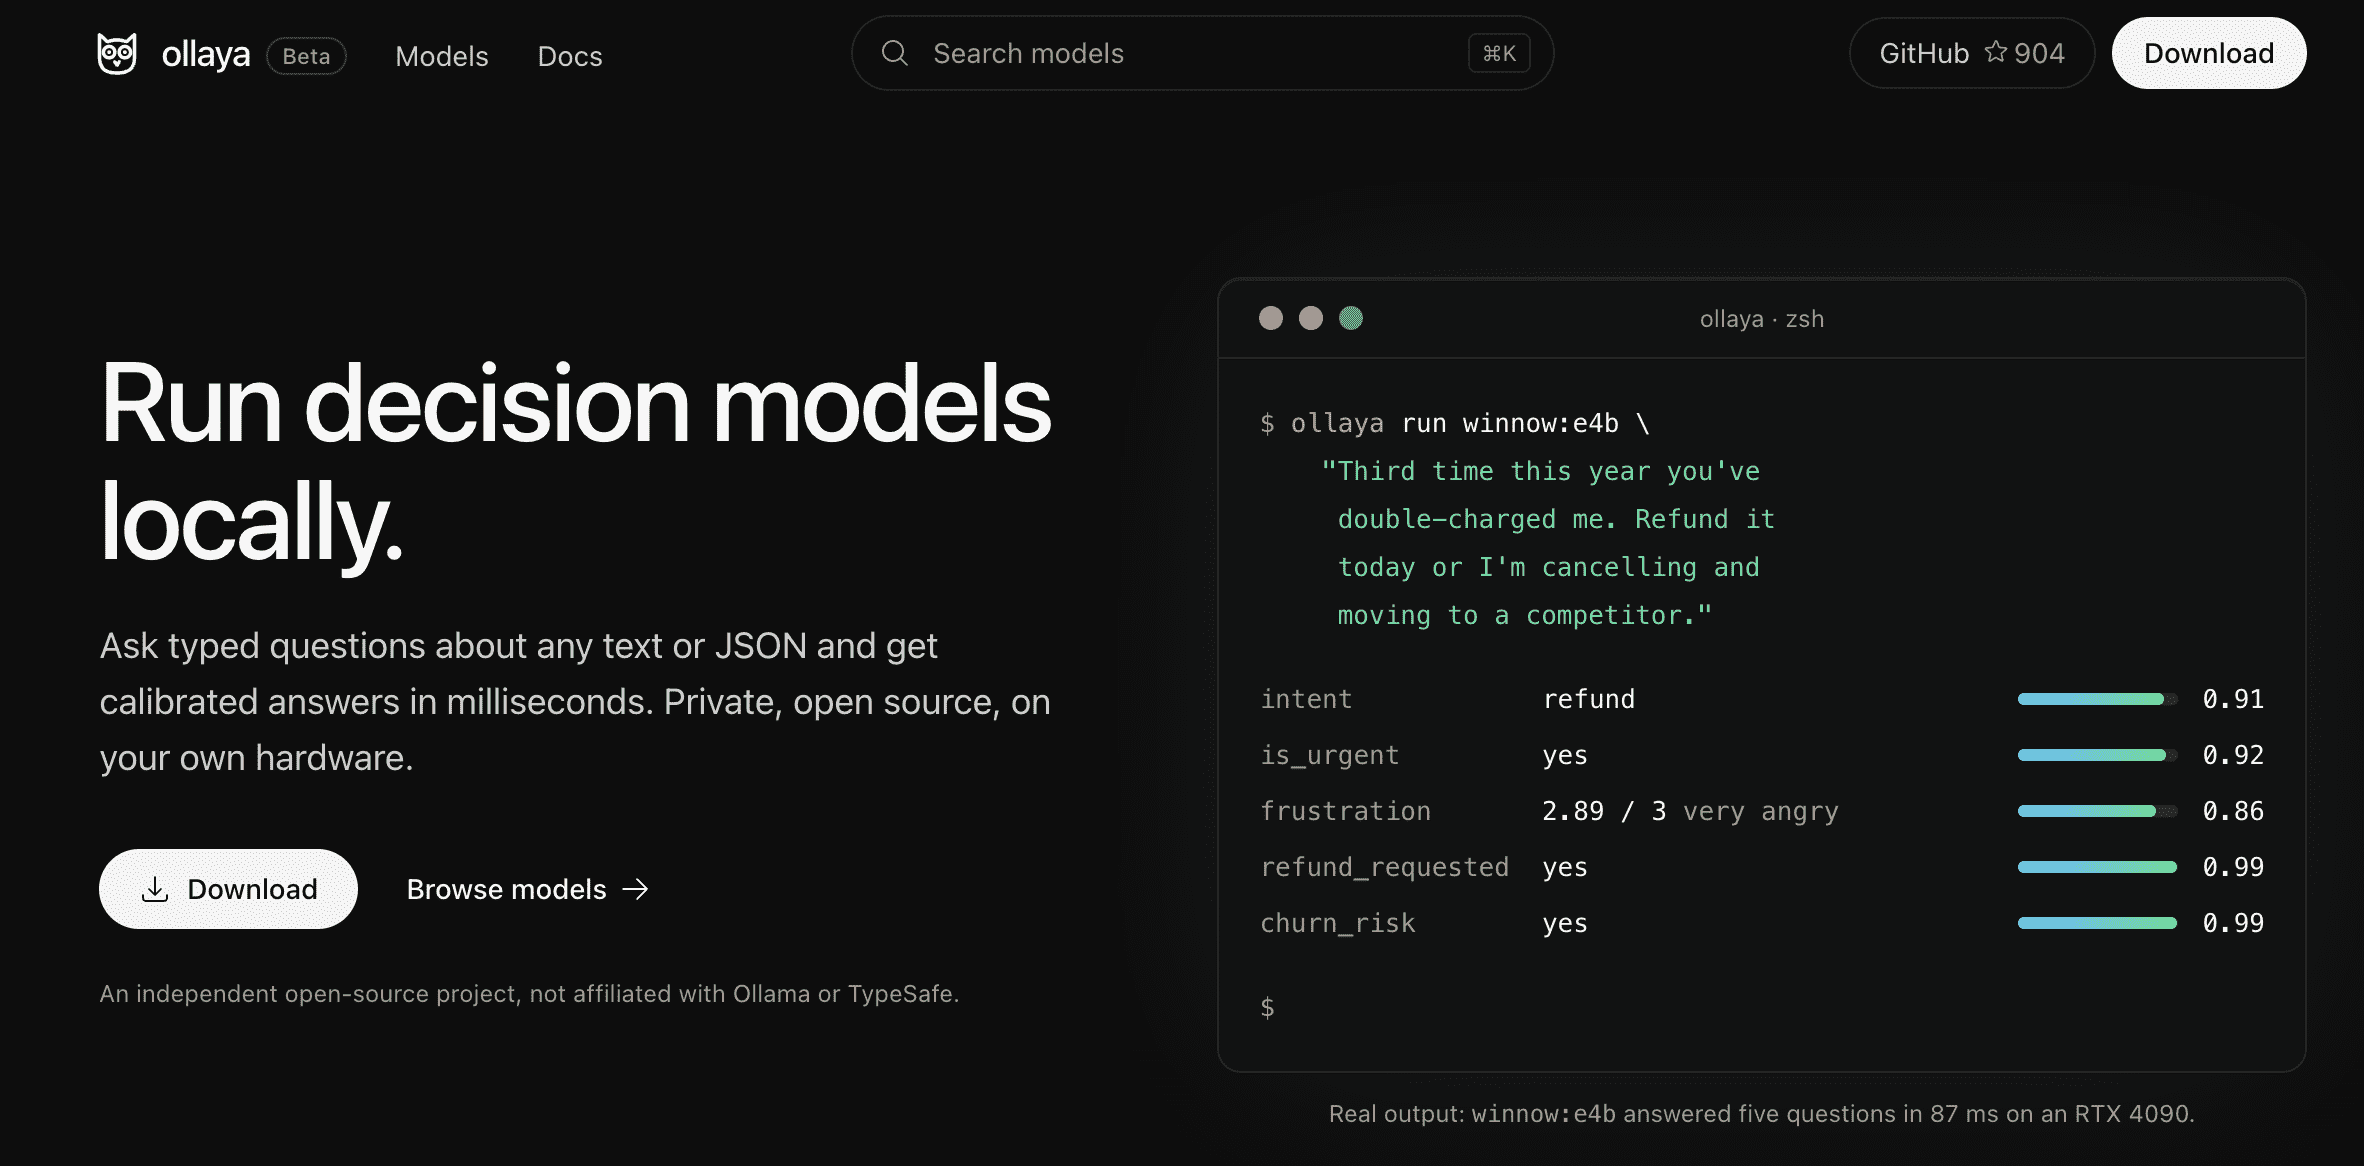
做业务开发时,很多场景并不需要大模型长篇大论。比如判断用户是想开票还是退款,或者检查 Agent 的 shell 命令有没有破坏性,系统要的只是一个明确的分类或评分。如果每次都调用生成式大模型逐字吐文本,不仅白白消耗几百毫秒甚至数秒,还容易碰上格式抽风。针对这种只要结构化结果的任务,决策模型(Decision Model)和本地运行时 Ollaya 提供了更轻更快的解法。
Ollaya 是什么
从工具定位来看,Ollaya 完整借用了 Ollama 的使用体验。Ollama 让我们通过单二进制文件和简单的 pull、run 命令在本地跑生成大模型,Ollaya 则把这套极简的操作逻辑搬到了开源决策模型上。为了方便两者在一台机器上同时常驻,Ollaya 故意把默认端口选在 Ollama 默认端口 11434 隔壁的 11435。
这种类比最实在的价值,在于让边缘环境和轻量级服务器也能跑起高质量的模型判定。传统的生成大模型动辄几十上百亿参数,边缘设备和普通轻量云服务器往往带不动。决策模型的体量大多只有几百兆,比如三四百兆的 Laya 模型,在纯 CPU 或者边缘适配上也能跑得很轻快,根本不需要昂贵的显卡支持。
普通大模型就算在回复里输出概率值,往往也存在偏高或者分布漂移的问题。决策模型输出的概率经过校准,能比较真实地反映置信区间。我们在业务代码里写判断逻辑就很踏实,比如规定危险操作概率超过 0.8 就强制拦截,低于 0.8 就自动放行,不需要再去做不可靠的文本正则。
本地安装体验
Ollaya 提供桌面客户端、命令行工具和 Docker 镜像,支持 macOS、Linux、Windows 和 WSL 2。Mac 用户除了用 CPU 推理,还可以通过 Apple MLX 调度 GPU。Linux 和 Windows 用户则支持 CUDA 13 调度 NVIDIA 显卡。
1 | curl -fsSL https://ollaya.dev/install.sh | sh |
在终端里拉起一个模型只需要一行命令。
1 | ollaya run laya |
因为模型不用逐字生成文本,推理耗时非常短。按照 Ollaya 官方在单张 RTX 4090 上的测试记录,Laya 模型跑五个问题,HTTP 接口响应中位数在 8 到 10 毫秒之间。算上本地调用的网络开销,也比走公网调用云端大模型快出很多倍。
Ollaya 支持的开源模型分工比较清晰。
Laya,参数量在 300M 到 400M 之间,支持 100 多种语言,专做是非判断、多选分类和区间打分。Decider,基于 Qwen3.5 架构,参数量有 0.75B 和 1.9B 两个档位,靠读取选项字母对应的 logits 做高精度推理。NLI,自然语言推理架构模型,把每个候选答案当成假设来算支持度,分类准确度很扎实。GLiClass,零样本分类模型,适合类别特别多的分类任务。Qwen3Guard,支持 119 种语言的安全模型,用来专门筛查输入文本和拦截 Agent 危险行为。
Java 与 Spring AI 实战
企业后端有大量的 Java 系统。Ollaya 在接口设计上兼容了 TypeSafe 的 System One API,直接对外暴露标准的 /v1/systemone 与 /v1/models 端点。社区维护的 spring-ai-starter-typesafe 拿过来就能直接用。
在 Spring Boot 3 工程的 pom.xml 里加上依赖。
1 | <dependency> |
配置 application.yml 时,把连接地址切到本地 Ollaya 的 11435 端口。
1 | spring: |
在业务里直接注入 TypeSafeClient。决策模型支持在单次请求里对同一段文本同时问好几个问题。TypeSafe 提供了三个常用原语,判断是非的 Noul,做多选分类的 Choice,以及给程度打分的 Score。
下面是检查 Agent 命令安全性并自动分流的写法。
1 |
|
这里不用写任何繁琐的 prompt 约束,也不用写正则去匹配 JSON 括号。模型返回来的字段都是强类型的,拿出来就能写业务逻辑。
把所有任务都堆给通用大模型,系统很容易卡在响应延迟和算力消耗上。
以后更合理的系统结构会把事情拆开,大模型去负责理解复杂上下文和生成长篇内容,轻量、本地运行的决策模型在几毫秒里把意图分流、风险审查和打分定下来。让每个模型做自己擅长的事,工程代码写起来省心,系统跑起来也稳当。