在业务风控与质检场景里,传统视觉方案往往两头不讨好。一条路是找算法团队训练专用 YOLO 模型,再搭一套 Python 微服务跑推理,运维成本高,交付周期也长。另一条路是直接调用通用多模态大模型,但大模型吐出来的自由文本经常格式错乱,坐标越界和幻觉让人很难直接放进自动化流水线。
TypeSafe AI 最近发布的 Jev 1.14.0 带来了一个关键突破。它首次支持全组合式多模态图片,还推出了原生的 Box 边界框类型。作为专为自动化流程设计的 System One 决策模型,Jev 把视觉识别与空间定位直接做成了强类型接口。配合 LangChain4j,Java 开发者不用碰任何算法微调,写几行业务代码就能在毫秒级内拿到确定的判断结论和目标坐标。
多模态图像调用的两种姿势
底层通讯会把图片转成 Base64 编码,并通过特殊的请求头与服务端协商,开发者在 Java 端完全感知不到这些底层细节。
目前模型支持 PNG 与 JPEG 格式。服务端对尺寸做了一些约束,单边像素要在 256 到 1568 之间,总像素不能低于 78400,单张图片体积上限是 16 MiB。在代码层面,LangChain4j 提供了两种常见的入参方式。
第一种是列表形式。如果一次请求只针对单张图片做简单的状态判断,把文本和图片一起放进列表即可。
1 | DecisionRequest request = DecisionRequest.builder() |
第二种是命名映射。当上下文包含多段文字,或者需要传入多张图片比对时,Map 结构更加清晰。我们可以给每张图片指定一个唯一的键名,提问时在问题里用反引号直接引用图片。
1 | DecisionRequest request = DecisionRequest.builder() |
在这张测试红色杯子的样本里,通过 Map 绑定传入图片,模型在异步模式下耗时只要 0.73 秒,给出了 98% 概率的杯子命中结果。
空间感知
判断目标在不在只是第一步,很多质检和风控还需要知道东西具体落在哪。Jev 1.14 增加了 Box 类型,LangChain4j 对应提供了专用的提问与应答类型。
模型返回的数据包含四个归一化浮点数,分别是 left、top、right 和 bottom,取值都在 0 到 1 之间,代表包围框相对图片宽高的比例,同时附带一个置信度得分。
工程落地时有一个务必留心的细节。Jev 的 Box 机制无论画面里有没有目标,都会强行给出一个框。因此在同一个请求里,必须把 Box 提问和是非判断成对使用。先用是非题确认目标存在,概率过了阈值,再去读取坐标。
1 | DecisionRequest request = DecisionRequest.builder() |
拿同时包含红杯子与香蕉的测试样本来看。
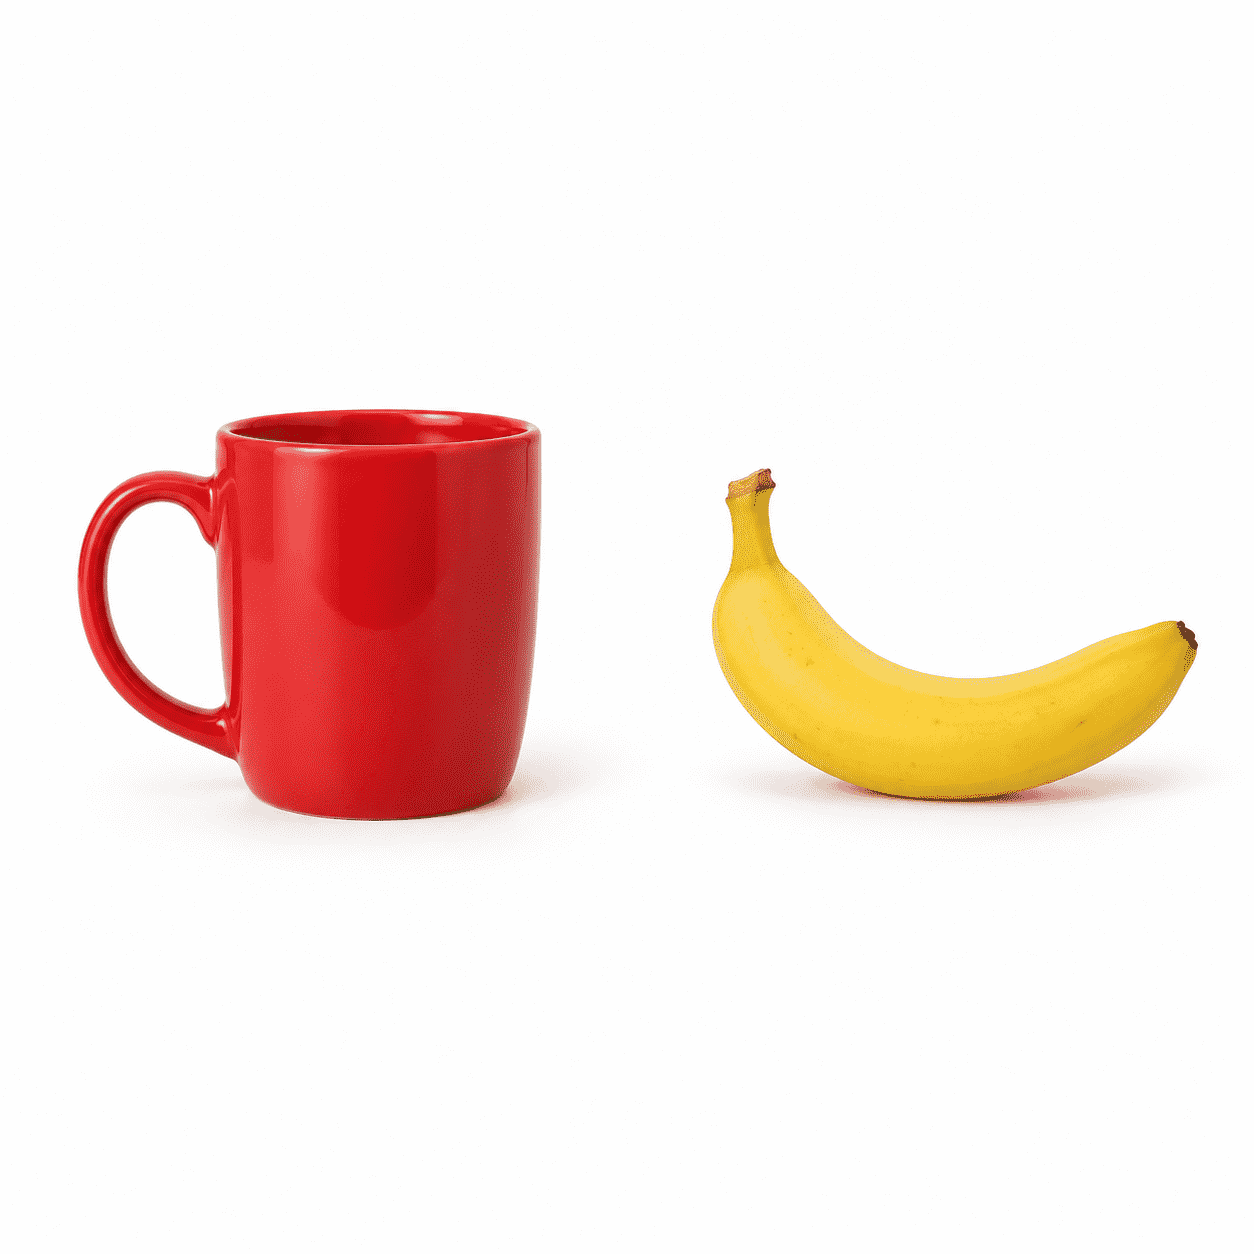
不用提前给任何位置提示,我们在单次请求里同时问了红杯子与香蕉的出现状态,并分别要了边界框。实测下来,杯子的 IoU 重合度达到 0.94,香蕉达到 0.92,整趟调用的端到端耗时在 1.3 秒到 2.5 秒之间。
社区里常见的几类传统方案平替
Jev 1.14 发布以后,开发者社区里很快讨论起这种把视觉判断做成确定性接口的做法。大家发现很多原本沉重的业务管道,其实可以换一种轻巧的搞法。
内容安全与违禁标识风控
过去为了在海量图片里抓违规水印或涉政标识,风控团队往往要串联好几个专用分类模型,或者接昂贵的商业审核接口。现在很多团队拿它做前置拦截。一次请求里同时问“有没有违规标识”以及“违规位置在哪”。模型给出的结论很干脆,返回的坐标还能顺手推给审核后台直接画红框,审核员一眼就能确认。这样既省掉了训练专用模型的周期,也不用承受大模型生成长文本时的延迟。
电商售后与物流定损自动化
买家申请退换货时上传开箱图,确认包装有没有压损或者破裂,过去全靠客服人工抽检,或者算法组花几个月标注样本做缺陷检测。不少人在社区里分享了更省事的做法。把照片喂给模型,设定好破损判定的概率阈值。一旦确认损坏,系统直接根据返回的 Box 坐标把受损部位裁切出来归档,整个定损流程立刻就能自动化流转。
自动化脚本
在界面自动化测试和 RPA 流程里,传统的像素模版匹配一直很难维护。屏幕分辨率稍微变一下,或者页面弹出新提示,脚本就会大面积报错。有开发者尝试把截图丢给模型,让它指出右上角关闭按钮或底部结算按钮的坐标。模型靠语义理解拿到位置,不再死抠固定的像素特征,自动化脚本也就没那么容易失效了。
现场合规与现场巡检
在工地安全帽佩戴检测这类场景里,传统方案每换一个新现场,往往都要重新采集样本做模型适配。现在只要把检查规则写进提示词,模型单次调用就能指出未佩戴安全防护的人员位置,把数周的模型调优压缩成了几个小时的业务规则配置。
从条件判断到物理世界感知的演进
从最初的主力版本走到 1.14,Jev 这类 System One 决策模型的路径很明确。最开始它主要帮后端系统替换那些脆弱的业务分支,用结构化判断代替模糊的规则。现在加入了图片多模态和 Box 类型,它开始有了理解物理空间和像素坐标的能力。
在 Java 生态里,LangChain4j 把底层交互做顺了。如果你的业务对稳定性要求很高,需要精准定位目标,又不想背上沉重的算法运维包袱,这种把视觉感知收敛成强类型接口的模式,很值得在生产环境里试一试。