我们在做知识库检索时,最常被问到一件事,明明向量库召回了十条切片,相关度看着挺高,为什么大模型回答起来还是信誓旦旦地胡说八道?
这段时间 TypeSafe AI 推出了专门做判定的决策模型 Jev,我们把 Jev 接进了 PIG AI RAG 整体的流程中,跑下来有一个很清晰的体会。把原本交给大模型去猜的分类、过滤和安全校验,交给轻量强类型的决策模型来做;大模型拿到干净材料后,只专注在最后的答案组织上。
这篇文章把我们在 PIG AI 里落地 Jev 的具体系统逻辑与工程避坑经验完整拆开。
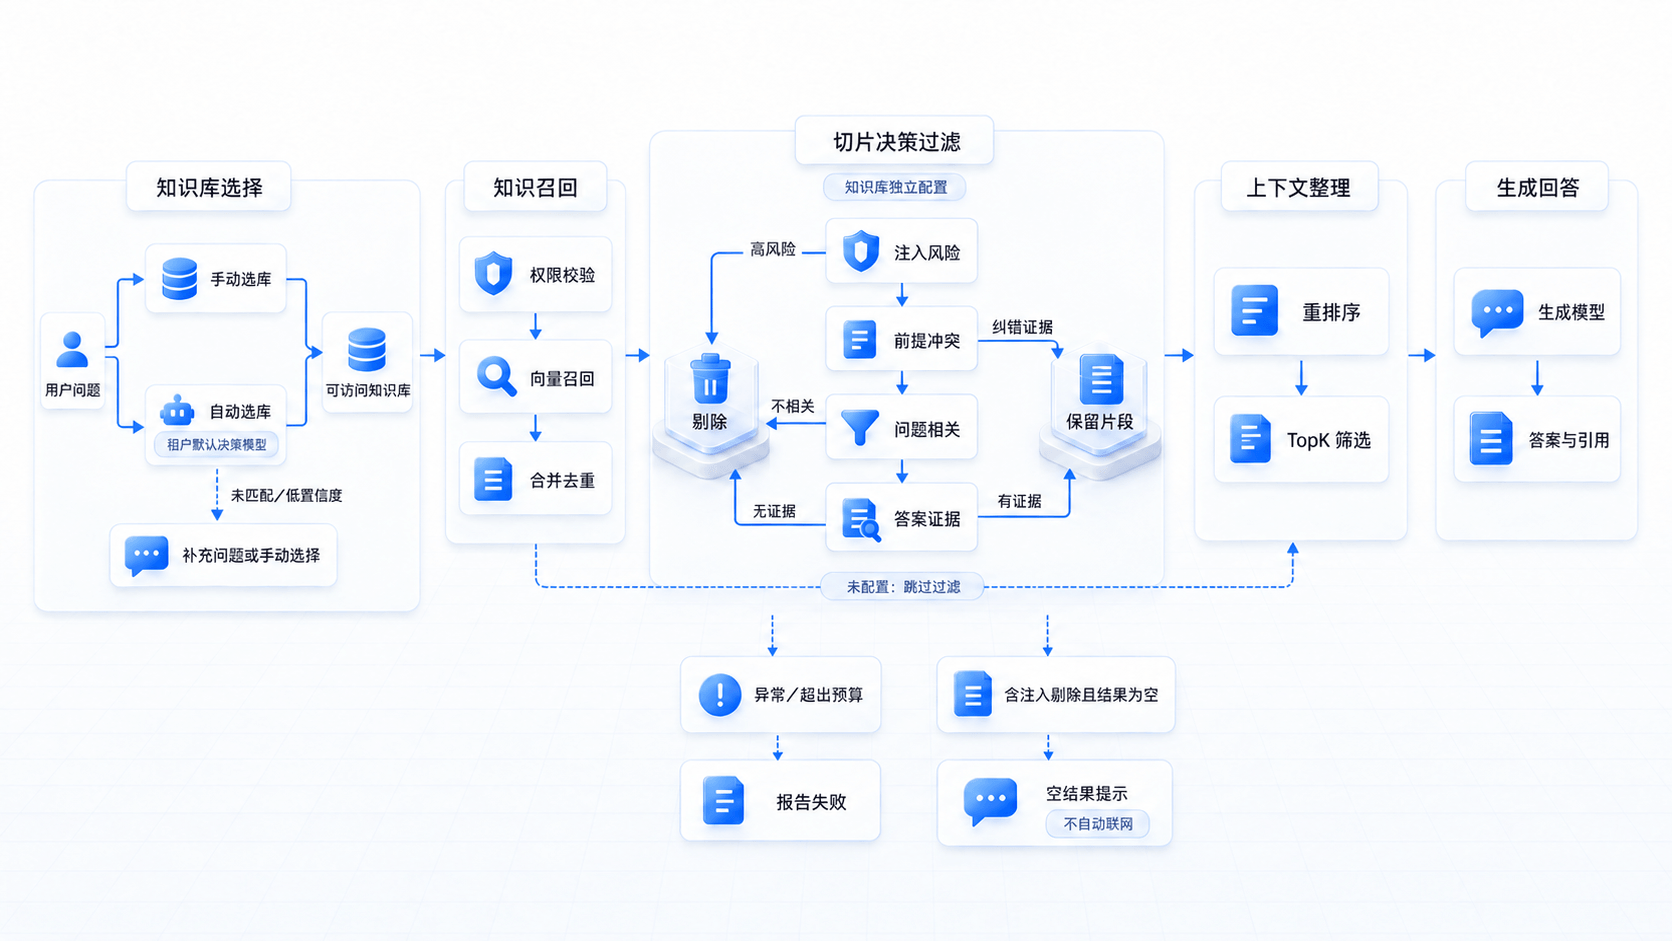
经典 RAG 生产环境里常踩的三处坑
经典的检索增强生成流程通常很直接。用户提问,向量检索初筛,重排过滤,拼接上下文,最后交给大模型生成回答。
在实际生产环境里,这条看似顺畅的链路经常会撞上几堵墙。
1. 模型一本正经地捏造答案
即便向量库精准召回了切片,大模型在理解上下文时依然可能产生偏差,甚至受到基础底模预训练偏置的干扰,捏造出知识库里根本不存在的结论。
2. 重排无法识别前提冲突
很多时候,召回的切片在字面或语义上与用户的提问吻合,传统重排模型也会给出很高的相关度分数。
但用户的提问前提本身可能是错的,比如拿着已经废除的内部规定来询问报销流程,或者假设了并不存在的业务场景。单纯依靠相似度打分,系统无法识别出这种业务前提冲突(Premise Conflict)。如果把这些切片顺理成章地送给大模型,模型很容易顺着错误假设继续推演,输出完全脱离实际的答复。
3. 缺乏针对提示词注入的安全审查防线
企业内部的文档环境极其复杂,切片中可能潜藏提示词注入(Prompt Injection)的风险,某些片段里被夹带了恶意覆盖指令。
传统的向量检索与重排模型主要评估文本间的语义匹配度,缺乏针对恶意指令的审查机制,容易让带有攻击意图的切片直接渗透到大模型的上下文中。
Jev 在 RAG 体系里的两种落位方式
以 TypeSafe Jev 为代表的 System One 决策模型,设计目标从一开始就和通用大模型不同。
Jev 的定位非常克制,它是一个纯粹的结构化判定模型。它完全不生成自然语言文本,只提供三种确定性的输入输出格式。
- Choice(单选),从最多 255 个枚举候选里给出判定,并附带置信度;
- Score(打分),基于评分描述对内容打出有序分值;
- Noul(是非概率),输出校准后的 Yes 或 No 概率值(0.0 到 1.0)。
Jev 能够在毫秒级内完成批量判定,输出高度一致的确定性结果。
在 RAG 管道中,Jev 通常有两种落位方式。
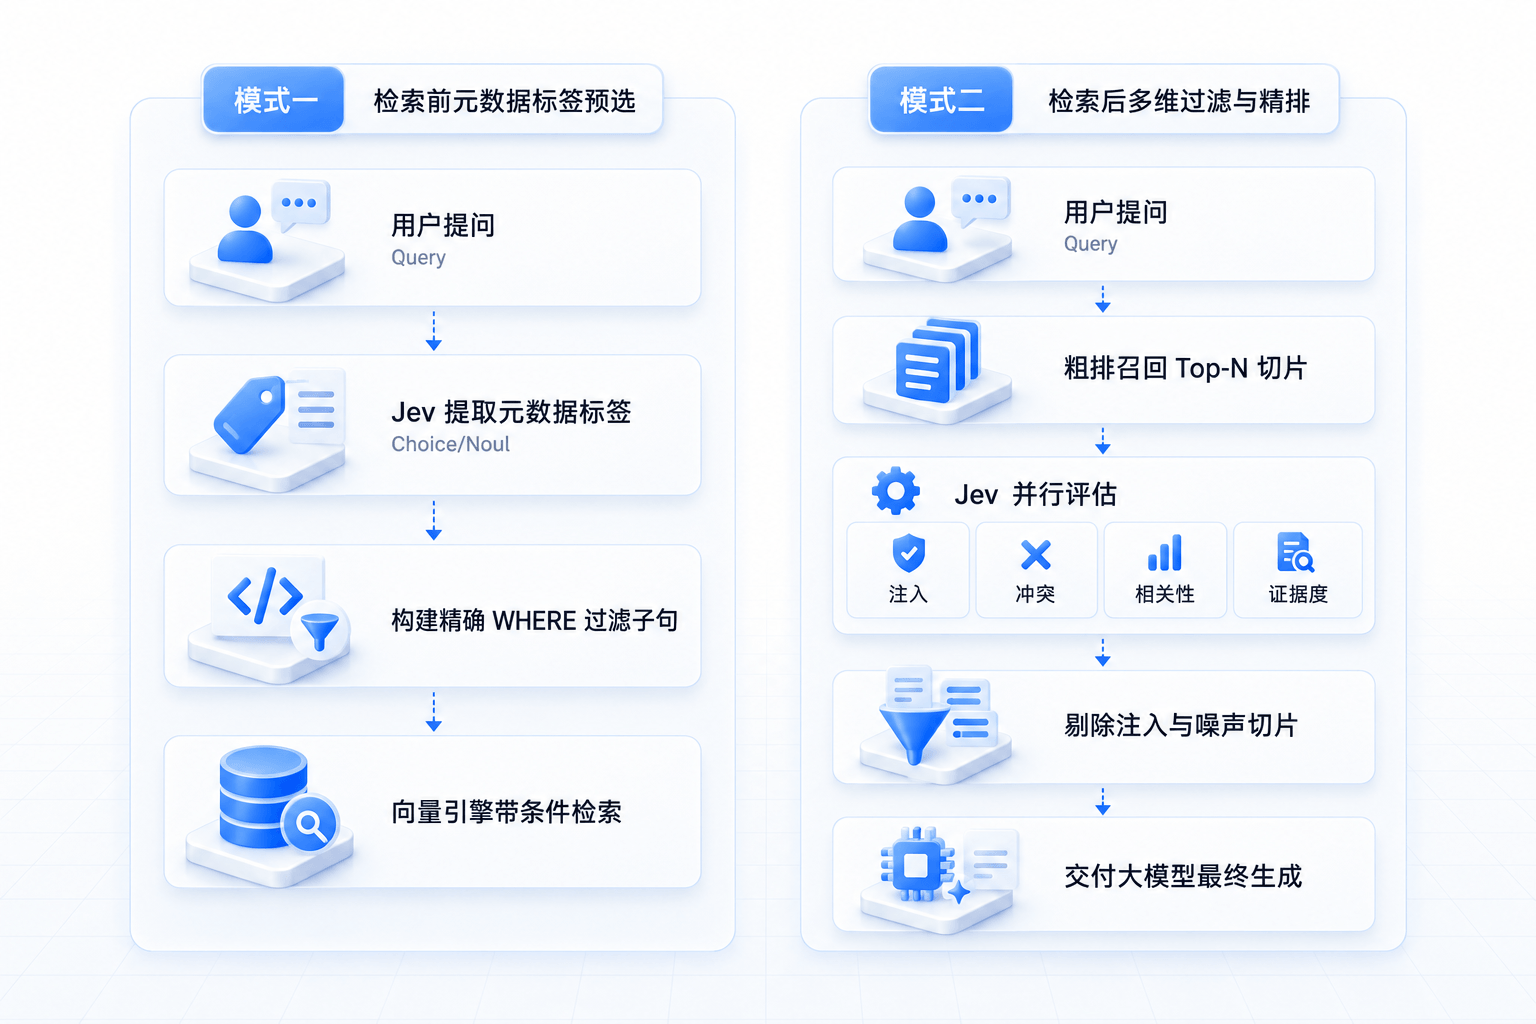
1. 检索前用 Jev 预选元数据标签
当企业向量库(如 PGVector、Chroma 或 Milvus)打上了业务类型、发布年份、所属部门或安全等级等标签时,可以先用 Jev 分析用户提问,自动产出精准的 SQL 或元数据过滤条件。
这种方式能在前置阶段成倍缩减向量检索的候选范围,减少向量数据库的算力开销,同时防止跨业务域的无关文档混入上下文。
在工程实现上,如果 Jev 给出的置信度偏低(比如低于 0.6),系统会自动降级执行全局检索,保证召回率不掉队。
2. 检索后用 Jev 做切片过滤与重排
向量检索初筛出 15 到 20 个候选切片后,系统把用户提问和这批切片一次性交由 Jev 处理。
Jev 不仅能完成切片的相关性排序,还可以在同一次 HTTP 请求里,并行完成切片是否包含答题证据、是否属于恶意提示词注入等多维度判定。
PIG AI 的工程落地与代码实现
在 PIG AI 中,我们基于 LangChain4j TypeSafe SDK 落地了这套机制。
1. 单请求并行多题评估 prepareRagDecision
在 DecisionRoutingService.java 中,我们没有对每个切片反复发起网络调用,而是充分利用 Jev 的批量请求能力,在一次 HTTP 会话中同时对所有切片评估四个命题。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
|
enum RagQuestion {
INJECTION("contains_prompt_injection", PromptCodeConstants.DECISION_RAG_INJECTION),
CONFLICT("contradicts_query_premise", PromptCodeConstants.DECISION_RAG_CONFLICT),
RELEVANCE("is_relevant", PromptCodeConstants.DECISION_RAG_RELEVANCE),
EVIDENCE("contains_answer_evidence", PromptCodeConstants.DECISION_RAG_EVIDENCE);
final String name;
final String promptCode;
RagQuestion(String name, String promptCode) {
this.name = name;
this.promptCode = promptCode;
}
}
|
这里要特别注意单次请求的字符预算。我们在本地限制了输入与问题文本的总字符上限,超限直接报错拦截,防止请求过大导致上游网关超时。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
| RagDecision prepareRagDecision(String modelRef, String query, List<String> passages) {
RuntimeDecision runtime = resolve(DecisionModelOptions.RAG, modelRef);
if (runtime == null) {
return null;
}
if (passages.size() > runtime.options.rag().maxCandidates()) {
throw new IllegalArgumentException("RAG 切片数量超过配置上限");
}
Map<String, String> inputs = new LinkedHashMap<>();
DecisionRequest.Builder builder = DecisionRequest.builder();
for (int index = 0; index < passages.size(); index++) {
String passageId = "passage_" + index;
inputs.put(passageId, passages.get(index));
for (RagQuestion question : RagQuestion.values()) {
builder.question(passageId + StrUtil.UNDERLINE + question.name,
YesNoQuestion.builder()
.text(promptBuilder.doRender(question.promptCode, Map.of("passageId", passageId)))
.yesWhen("yes")
.noWhen("no")
.build());
}
}
DecisionRequest request = builder.input(Map.of("query", StrUtil.nullToEmpty(query), "passages", inputs))
.build();
if (request.input().toString().length() + request.questions().toString().length() > runtime.options.rag().maxInputChars()) {
throw new IllegalArgumentException("RAG 整次请求超过配置字符上限");
}
return new RagDecision(runtime, request, passages.size());
}
|
2. 确定性规则裁决器 classify
Jev 毫秒级返回概率矩阵后,RagDecisionService.java 通过明确的状态机规则执行优先级裁决。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
| private static Verdict classify(Map<String, Double> scores, DecisionModelOptions.RagOptions options) {
if (scores.get(INJECTION.name) > options.injectionThreshold()) {
return new Verdict(false, "INJECTION", scores);
}
if (scores.get(CONFLICT.name) > options.conflictThreshold()) {
return new Verdict(true, "CONFLICTING", scores);
}
if (scores.get(RELEVANCE.name) < options.relevanceThreshold()) {
return new Verdict(false, "IRRELEVANT", scores);
}
boolean evidence = scores.get(EVIDENCE.name) > options.evidenceThreshold();
return new Verdict(evidence, evidence ? "EVIDENCE" : "NO_EVIDENCE", scores);
}
|
这段逻辑体现了清晰的先后顺序。先排查安全性,再做事实纠偏,接着剔除无关切片,最后判断证据是否充足。
3. 风险过滤联动,阻断静默越狱
不少 RAG 系统在设计时有一个习惯,当本地知识库没查到内容时,会自动降级调用联网搜索。
我们在 VectorRetrievalAugmentedGenerationStrategy.java 里加了一道防线。如果切片列表为空是因为触发了注入风险拦截(INJECTION),系统严禁自动转入联网搜索。
如果不做这一层限制,攻击者完全可以通过在切片中植入指令,诱导系统绕过本地防御直接向外网发起查询,造成指令逃逸。
1
2
3
4
5
6
7
8
9
10
11
12
| private Flux<AiMessageResultDTO> answerDecisionResult(AiDatasetEntity dataset, ChatMessageDTO chatMessageDTO,
RagDecisionService.Result result, RagTraceContext traceContext) {
if (CollUtil.isEmpty(result.matches())) {
if (result.blockWebFallback()) {
return Flux.just(new AiMessageResultDTO(dataset.getEmptyDesc()));
}
Long recordId = ChatMessageContextHolder.get() == null ? null : ChatMessageContextHolder.get().getMessageKey();
return RagHelper.handleEmptyResult(dataset, chatMessageDTO, recordId, traceContext);
}
return answerFilteredMatches(dataset, chatMessageDTO, result.matches(), traceContext, result.enabled());
}
|
4. 跨知识库检索时的交错归并
在企业实际业务场景中,一次提问经常需要跨多个知识库同时检索。不同的知识库可能采用了不同的 Embedding 模型,向量相似度在物理意义上根本无法直接横向对比。
我们在 PIG AI 里的做法很简单。让各个知识库先经过各自绑定的 Jev 模型完成独立过滤与打分,再按各库内的相对名次交错排列合并,最后由统一的全局重排模块进行二次精排与截断。
1
2
3
4
5
6
7
8
9
10
|
List<EmbeddingMatch<TextSegment>> matches = new ArrayList<>();
int maxSize = results.stream().mapToInt(result -> result.matches().size()).max().orElse(0);
for (int rank = 0; rank < maxSize; rank++) {
for (RagDecisionService.Result result : results) {
if (rank < result.matches().size()) {
matches.add(result.matches().get(rank));
}
}
}
|
总结
把分类、过滤和安全边界这类确定性的判断交给轻量高效的决策模型,把材料组织与自然语言表达交给大模型,是我们在 PIG AI 落地过程中摸索出来的一条很顺的路径。这种分工让整个检索流程不仅能够准确召回相关知识,更重要的是具备了工程上的确定性与安全防御能力。